AI 워크플로우 자동화 잘 하는 법, 직접 적용 후기

여기까지 잘 따라오셨습니다.
1편에서는 AI 워크플로우 자동화가 무엇인지, 2편에서는 에이전트와 코드를 나누는 WAT 프레임워크를 다뤘죠.
이제 마지막으로 잘 하는 법과, 제가 실제 제품에 어떻게 적용했는지를 알려드릴게요.
답부터 말하면 AI 워크플로우 자동화를 잘 하는 핵심은 프롬프트 실력보다 기준을 정하고 검증하는 구조를 만드는 데 있습니다.
AI 워크플로우 자동화, 처음 만들 때 무엇부터 챙길까?
잘 돌아가는 워크플로우를 만드는 흐름은 단순합니다.
계획을 세우고, 질문을 받고, 실행하고, 첫 실행을 지켜보며 고치는 것.
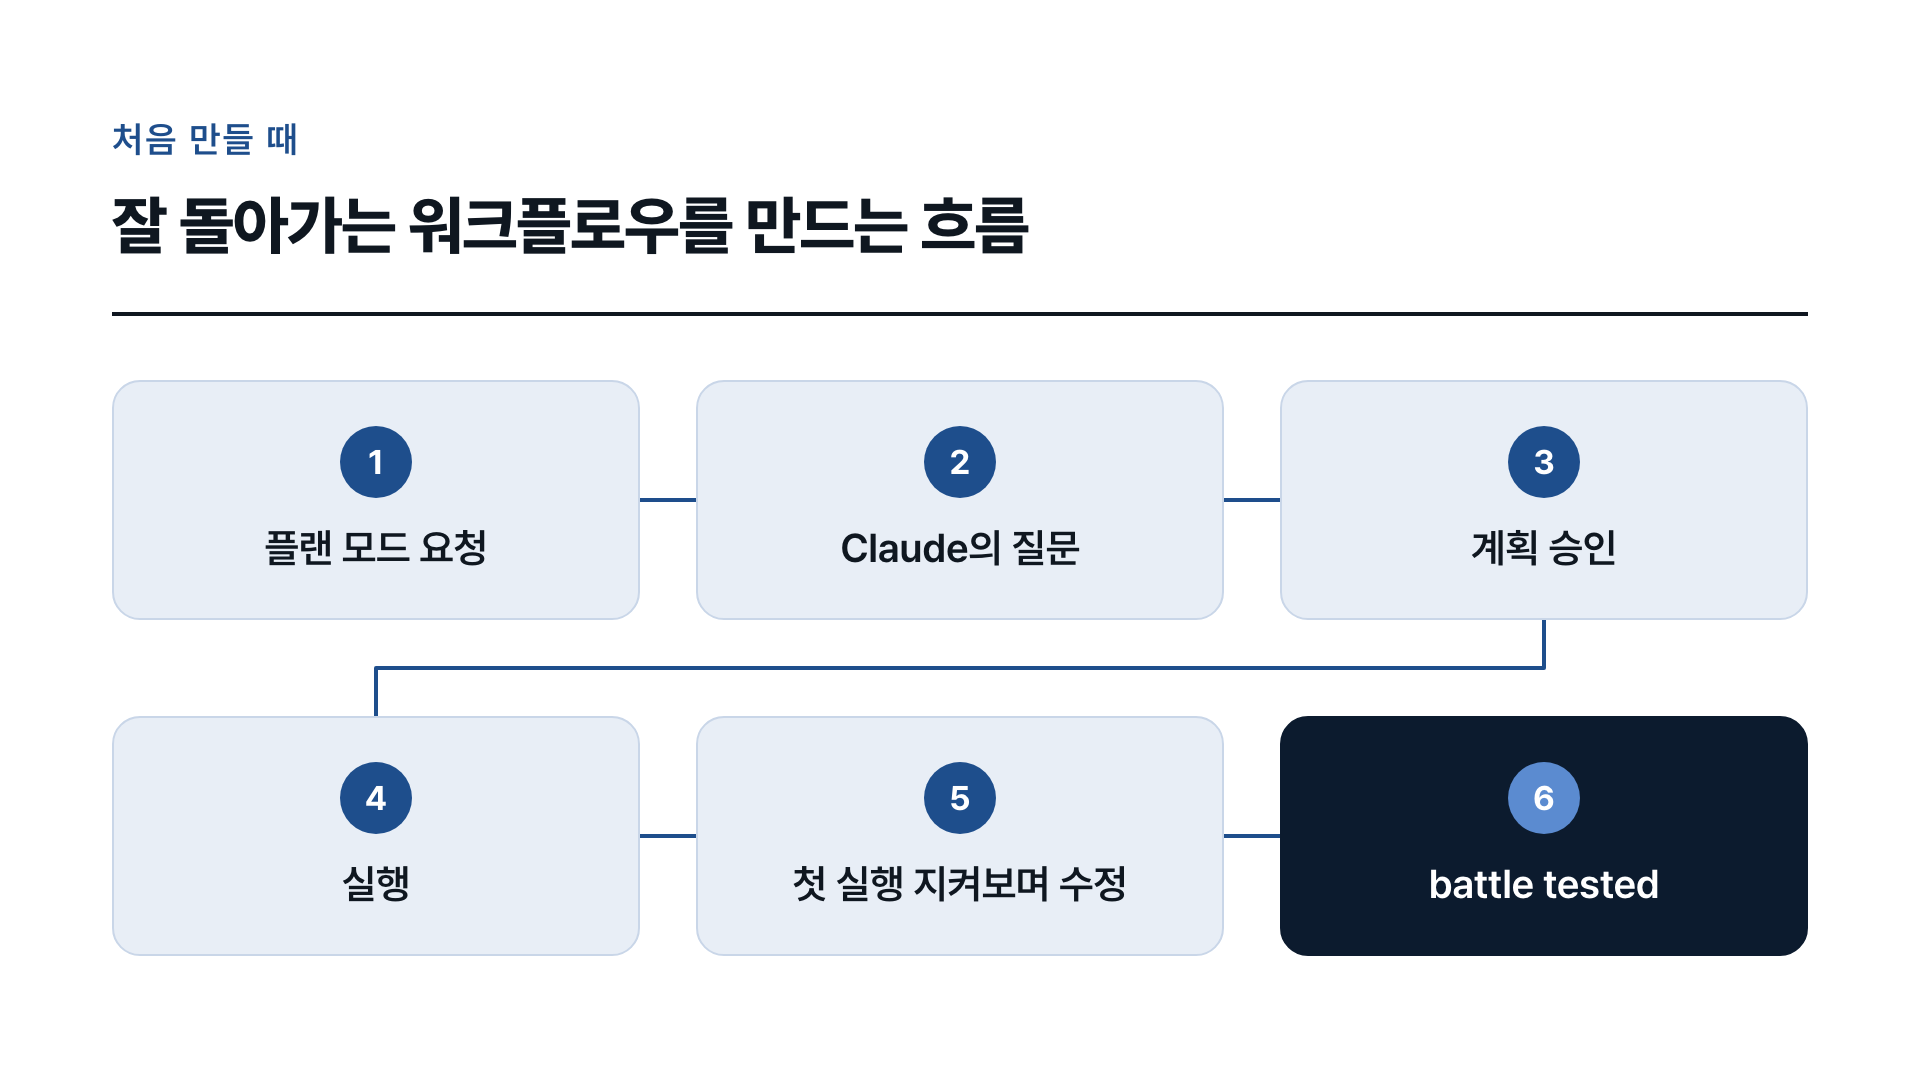
1. 플랜 모드에서 일부러 모호하게 요청하기
첫 요청은 일부러 모호하게 던지고, "궁금한 건 물어봐 달라"를 덧붙여 보세요.
예를 들어 경쟁사 분석을 맡기면 Claude Code가 경쟁사를 어떻게 찾을지, 얼마나 자주 돌릴지 같은 객관식 질문을 쏟아내고, 엣지 케이스 처리까지 계획에 넣습니다.
"95% 확신할 때까지 진행하지 마라"는 한 줄이면 이해하기 전에는 빌드를 시작하지 않습니다.
2. CLAUDE.md는 가볍게, 컨텍스트는 비우면서
CLAUDE.md는 매 메시지마다 먼저 읽히는 시스템 프롬프트라서, What(구조), Why(목적), How(일하는 방식)만 담아두면 충분해요.
컨텍스트도 차오를수록 품질이 떨어지니(context rot), 60%를 넘으면 /compact나 /clear로 비워줍시다.
3. 첫 실행은 지켜보고, 고칠 땐 워크플로우도 같이
첫 실행에서는 꼭 무언가 깨집니다.
PDF 보고서라면 흰 로고가 배경에 묻히는 식이죠. 이럴 땐 "로고가 안 보인다, 조사해서 고쳐라" 한마디면 원인을 찾아 고칩니다.
포인트는 고칠 때 워크플로우와 도구까지 업데이트해서 같은 오류가 다시 안 나게 하는 것입니다.
이 과정을 몇 번 거쳐 구멍을 메운 상태를 battle tested라고 부릅니다.
흔한 실수 2가지
가장 흔한 실수는 목표가 모호한 것, 그리고 완료 조건이 없는 것입니다.
"링크드인 리드 스크래퍼"보다 "테크 기업 CEO 프로필 75개, 이름·이메일·링크를 시트에, 75개면 끝"이 낫다는 거죠.
특히 2번, 언제 멈출지 정해주지 않으면 에이전트는 끝없이 돕니다. 이건 뒤에서 제 사례로 다시 나옵니다.

체리시사인에 적용한 방법
여기부터는 제 이야기입니다.
저는 AI 점성술 앱 체리시사인을 직접 개발해 운영하고 있습니다.
그런데 분석 프롬프트를 고칠 때마다 제가 직접 기능을 돌려보고, 결과를 읽고, 피드백을 주고, 다시 돌리는 일이 은근히 큰 부담이었어요.
그래서 지금까지 다룬 개념을 실제 프로젝트 구조로 옮겼습니다.
1. 2026년 9월 중순, WAT 구조를 들였습니다
체리시사인에 WAT 구조를 실제로 도입한 건 2026년 9월 중순입니다.
폴더는 이렇게 생겼어요.
workflows/
  fix_bug.md     # 버그를 고칠 때 따르는 확인 순서
lessons/
  2026-10-28_e2e-server-blocked.md   # 버그 하나에 기록 하나
  ...
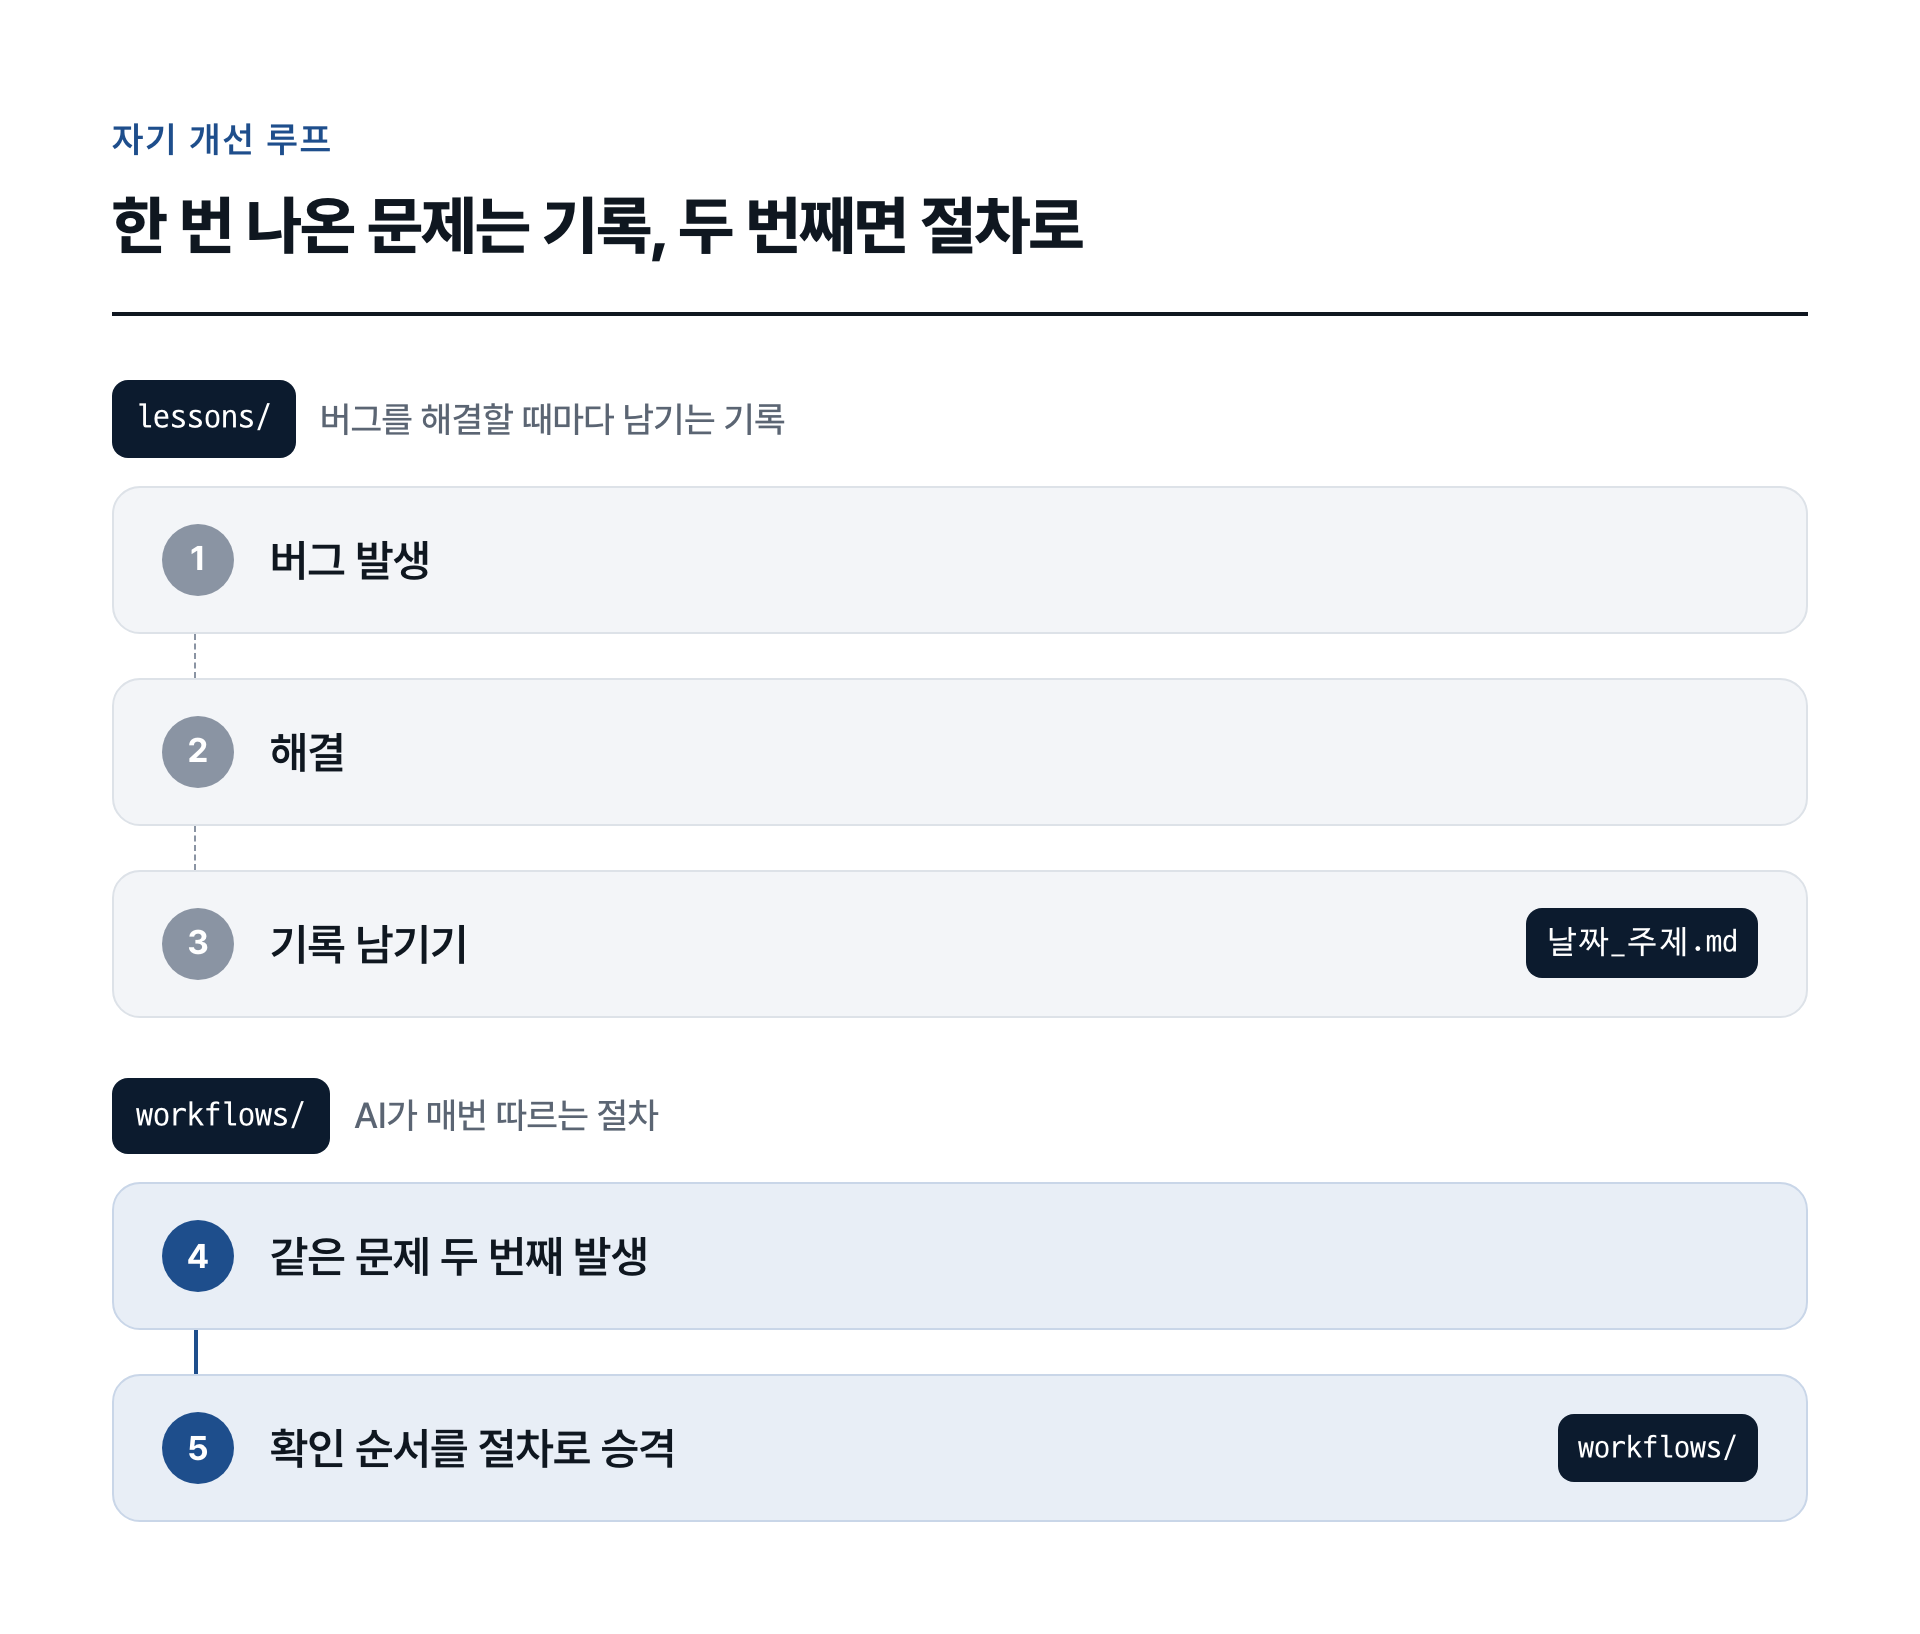
workflows/는 AI가 매번 따르는 절차, lessons/는 버그를 해결할 때마다 남기는 기록입니다.
기록 파일 이름은 날짜_주제.md로 통일했습니다.
2. 한 번 나온 문제는 기록, 두 번째면 절차로
자기 개선 루프의 기본은 "오류를 고친 뒤 다시 안 생기게 워크플로우를 업데이트한다"입니다.
저는 여기에 기준을 하나 더 얹었습니다.
같은 문제가 두 번째면 워크플로로 올린다.
처음 나온 버그는 lessons/에 기록만 남깁니다.
같은 문제가 또 나오면, 그 기록의 확인 순서를 workflows/로 승격해 AI가 매번 따르는 절차로 만듭니다.
3. 기록이 실제로 잡아낸 버그
9월 중순 이후 lessons/에 쌓인 기록은 7건입니다.
그중 기록이 다시 쓰여서 같은 문제를 빨리 잡거나 막은 경우가 3건이고, 나머지 4건은 아직 같은 버그가 다시 나오지 않아서 효과는 확인하지 못했습니다.
E2E 서버가 뜨지 않는 문제
저는 Playwright로 실제 브라우저에서 E2E 테스트를 돌려, AI가 UI 버그까지 스스로 찾아 고치게 해뒀습니다.
그런데 10월 28일, 그 E2E 서버가 뜨지 않는 증상이 하루에 두 번 났어요.
첫 번째는 우회만 하고 넘어갔습니다.
두 번째에는 2026-10-28_e2e-server-blocked.md 기록을 보고 근본 원인을 찾았습니다. pnpm 버전이 12로 고정돼 있던 거였죠.
두 번째였으니 규칙대로, 실행 환경 오류의 확인 순서를 workflows/fix_bug.md에 올렸습니다.
10월 29일에 또 터졌습니다.
이번엔 브랜치를 바꿀 때마다 꺼진 줄 알았던 개발 서버가 포트를 붙잡고 있어서, E2E가 연결 오류로 실패했어요.
기록에 적힌 순서(포트를 쥔 프로세스를 찾고, 어디서 띄운 건지 확인한 뒤 끄기)를 그대로 따라 몇 분 안에 풀었습니다.
구글 태그 문제
10월 28일, 보안 정책(CSP)을 고쳐 배포했는데 그 수정이 GA 방문 수집 주소를 새로 막았습니다.
기록에 있던 "배포 뒤 운영에서 막힌 요청을 다시 모은다"는 확인 단계 덕분에 15분 안에 잡았어요.
10월 30일 "구글 애즈가 태그를 못 찾는다"는 문제가 왔을 땐, 앞 기록으로 CSP는 이미 허용돼 있다는 걸 바로 확인하고 진짜 원인(태그를 불러오는 모양)으로 곧장 갔습니다. 두 번째였으니 이 확인 순서도 워크플로로 올라갔고요.
테스트의 시계 차이 문제
10월 29일 병합 테스트에서 운영 DB 통합 테스트 하나가 "JWT 발급 시각이 미래"라는 오류로 실패했습니다.
2026-10-28_test-created-at-clock-order.md에 "DB 서버와 앱의 시계가 몇 초 어긋날 수 있다"가 남아 있어서, 일시적인 시각 차이로 판단하고 다시 돌려 통과를 확인했어요.
기록이 없었다면 멀쩡한 코드를 고치러 들어갔을 겁니다.
4. 검사 기준을 주고, 최대 3회까지만 자가 수정
AI 점성술 분석 프롬프트를 바꿀 때마다 저는 검사 기준을 함께 줍니다. 예를 들면 이런 것들이에요.
- 사용자가 이해하기 어려운 용어를 쓰지 않는다. 중학생 수준의 독해력으로 피로감 없이 읽혀야 한다.
- 오타와 문법 오류가 없다.
- 읽었을 때 흐름이 어색한 부분이 없다.
결과가 기준에 못 미치면 AI가 스스로 고치고 다시 검사하는데, 최대 3번까지만 하고 저에게 보고합니다.
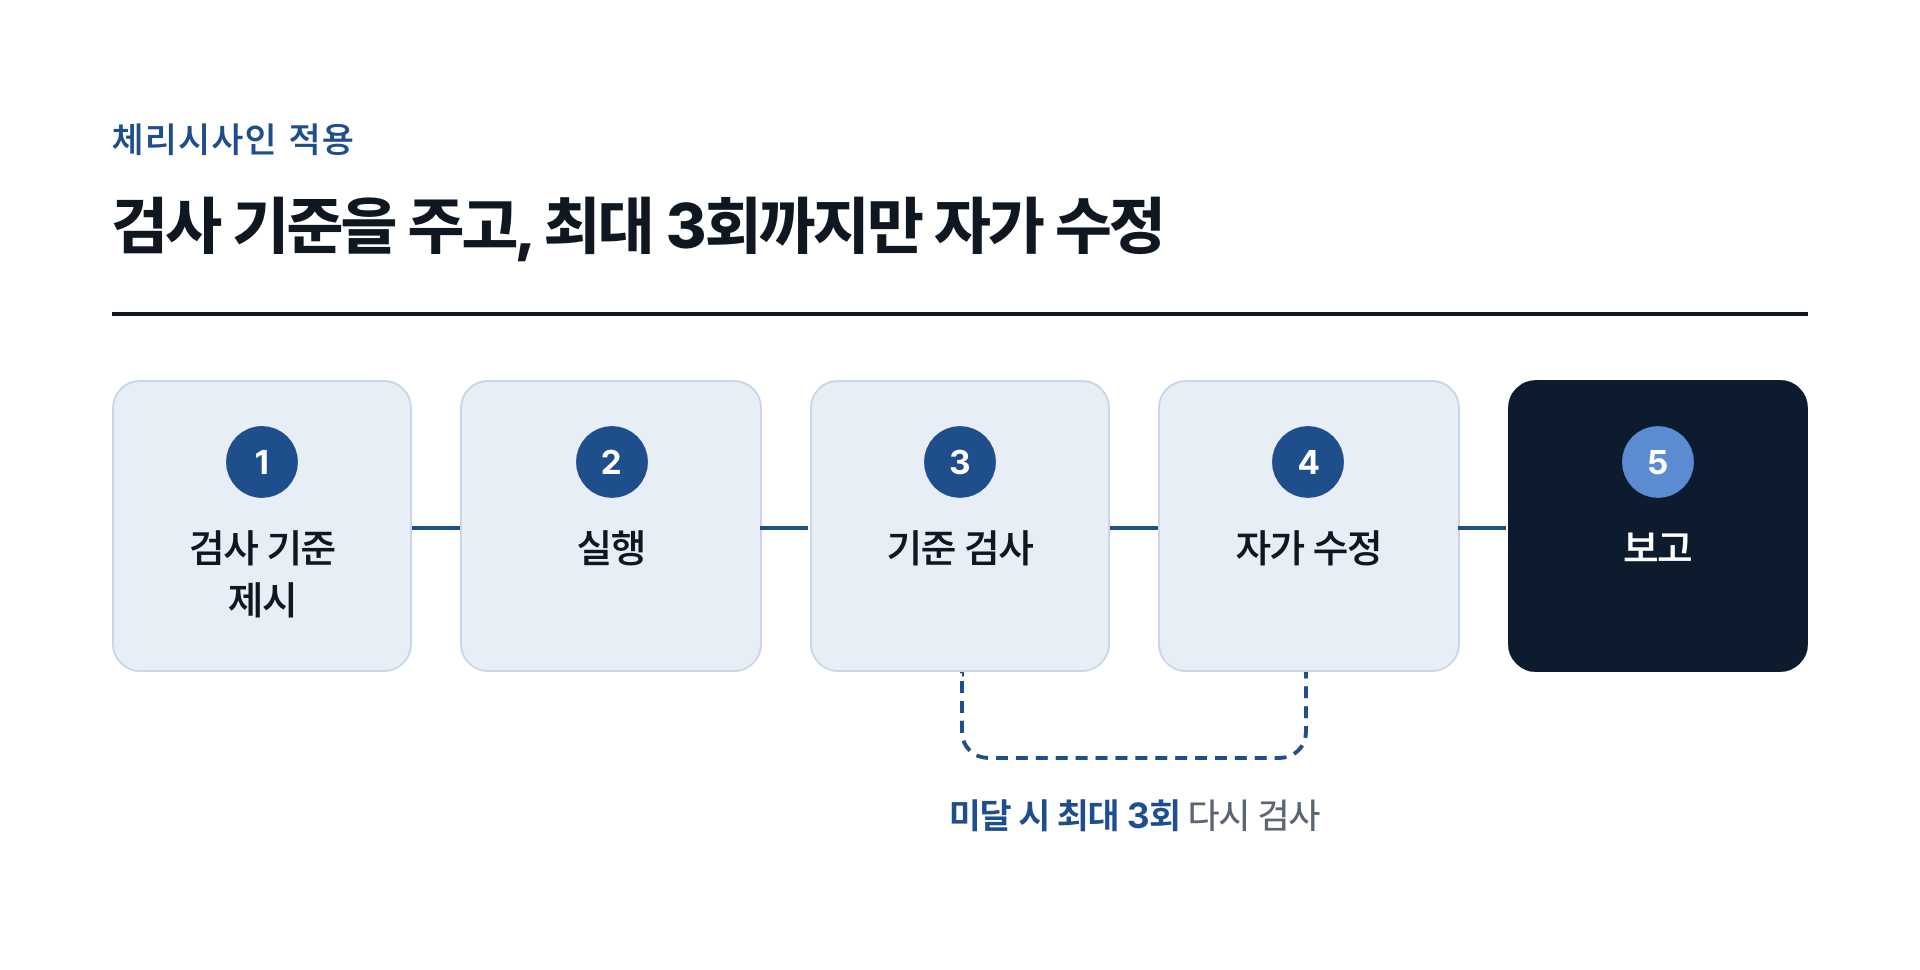
횟수를 정한 데는 두 가지 이유가 있습니다.
첫째, 횟수를 정해두는 것 자체가 핵심이었습니다. 정하지 않으면 에이전트는 무한히 검사합니다.
앞에서 본 실수 2번, 완료 조건이 없는 경우와 같은 이야기예요.
에이전트는 언제 멈출지 알아야 합니다. 결승선이 없으면 과하게 복잡하게 만들거나 같은 일을 계속 반복하면서, 답은 간단한데도 시간을 낭비합니다.
둘째, 숫자가 3인 이유는 비용과 효과입니다.
분석에는 Gemini를 쓰는데, 검사와 자가 수정이 전부 Gemini 호출이라 횟수를 열어두면 비용이 끝없이 나갑니다.
그리고 제가 운영해 보니 3회 정도면 에러의 약 90%가 고쳐지더라고요.
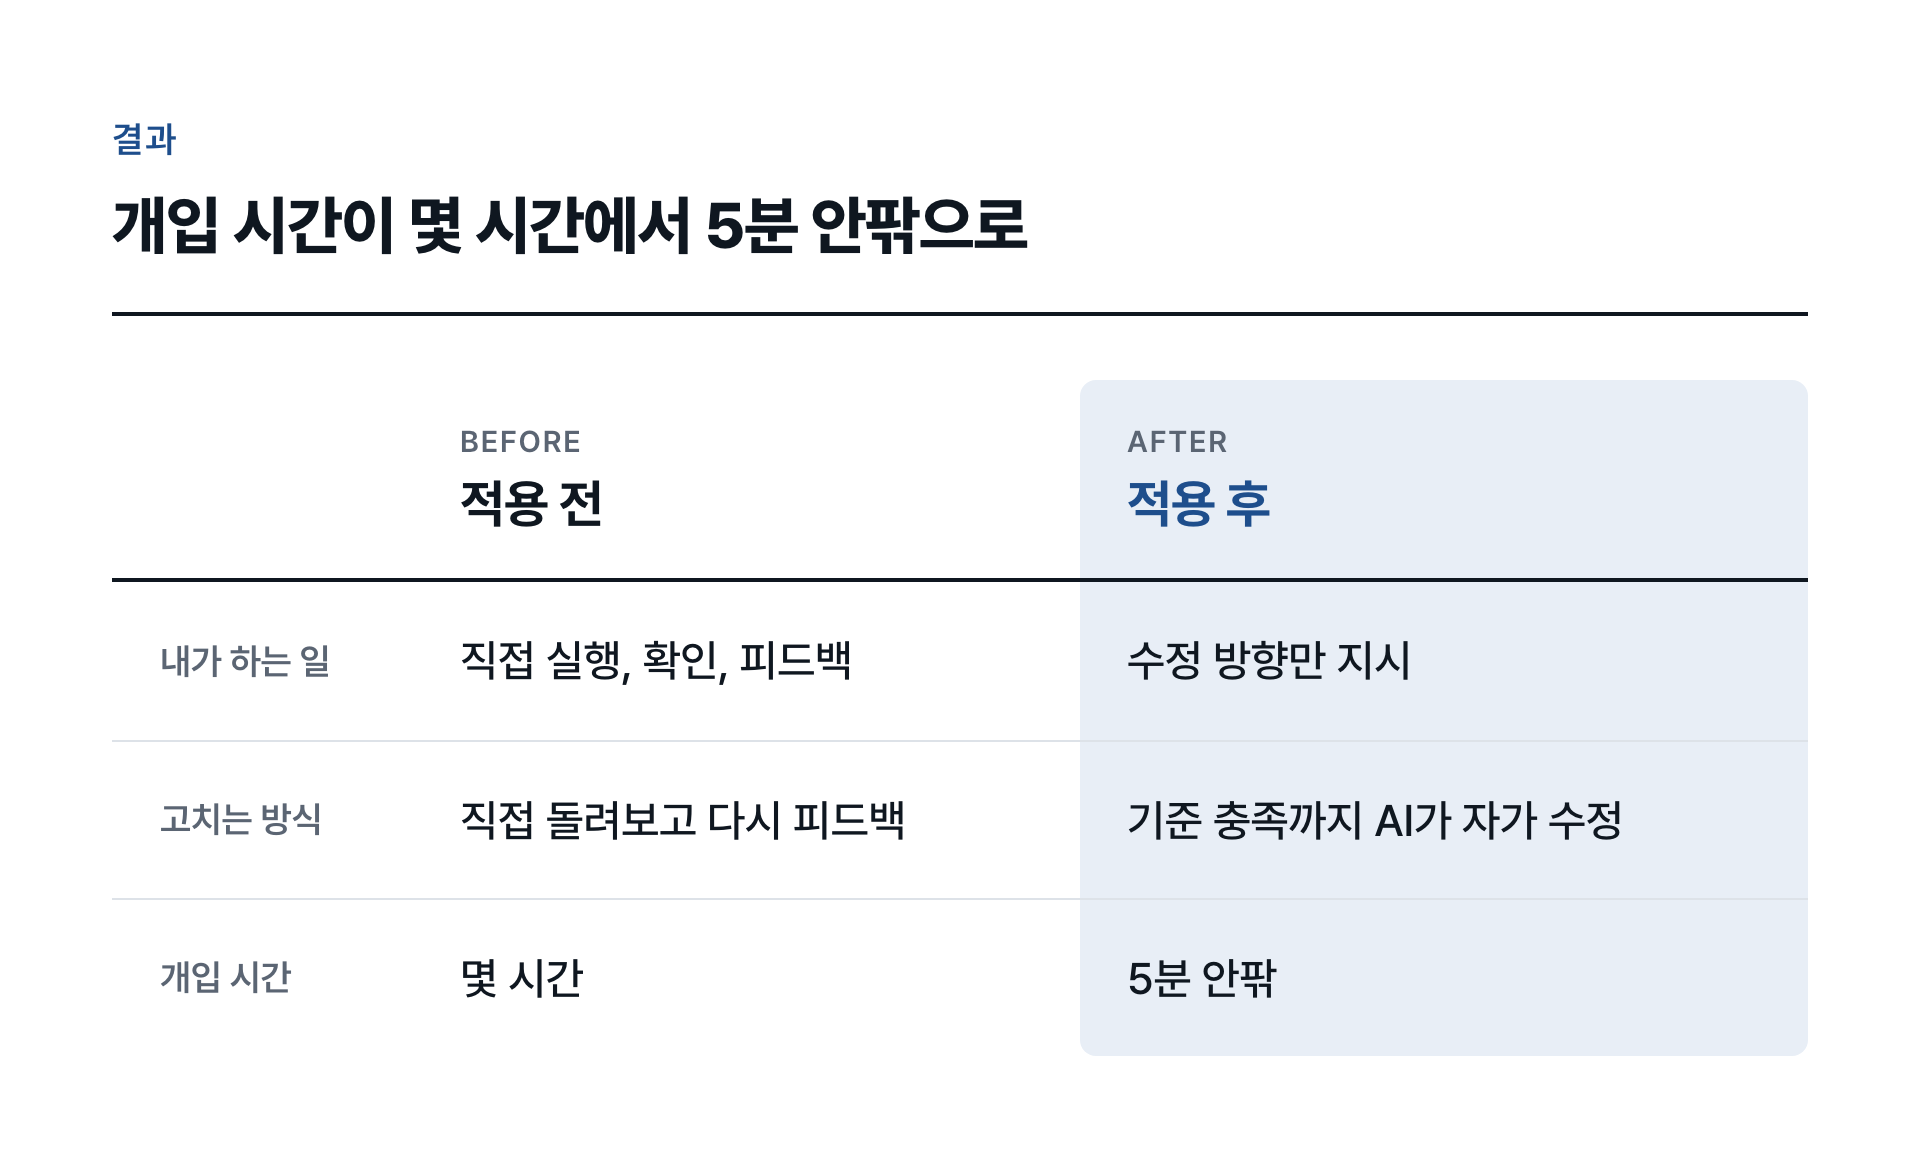
결과: 개입 시간이 몇 시간에서 5분 안팎으로
예전에는 프롬프트를 고칠 때마다 직접 돌려보고 피드백하느라 몇 시간이 걸렸습니다.
지금은 수정 방향만 지시하면, 제가 넣어둔 기준에 맞을 때까지 AI가 알아서 고칩니다.
제가 개입하는 시간은 5분 안팎으로 줄었고, 개입은 줄이면서 품질은 지켰습니다.
마치며
1편에서 AI 워크플로우 자동화가 무엇인지, 2편에서 에이전트와 코드를 어떻게 나누는지, 이번 편에서 어떻게 굴리는지를 봤습니다.
플랜 모드로 질문을 받고, CLAUDE.md를 가볍게 두고, 고친 문제는 기록해 두 번째에 절차로 올리고, 멈출 지점을 숫자로 정해두는 것.
AI에게 일을 맡기는 것보다 맡긴 일을 검증하는 구조를 만드는 쪽이 더 어렵고, 결과를 좌우하는 일에 가깝습니다.
AI를 "시키는 도구"로 보면 매번 결과를 직접 확인해야 합니다. 하지만 "기준을 설계하고 검증 구조를 만드는 대상"으로 바꿔 보면, 사람은 기준과 최종 판단만 맡으면 되는 것 같습니다.
참고: Build & Sell with Claude Code (10+ Hour Course), https://www.youtube.com/watch?v=mpALXah_PBg